
 - 高性能GPU/模拟接口设计平台

数据饥饿与算力冗余的悖论
很多人以为,GPU电路的性能天花板由晶体管密度或制程工艺决定,其实不然。在超算中心与AI训练集群的实测数据中,一个被刻意隐藏的真相逐渐浮现:当计算单元的并行度突破10^6量级后,数据供给效率开始主导实际算力输出。这种“算力冗余与数据饥饿”的悖论,在2023年某头部云服务商的内部压力测试中暴露无遗——其搭载H100集群的POD单元在ResNet-50训练中,计算单元利用率长期低于58%,而根源竟是PCIe 5.0总线无法满足梯度同步的带宽需求。
案例解剖:银川超算中心的赛制级压力测试

2024年Q2,位于银川中关村创新基地的国家级超算中心进行了一场极具技术深度的压力测试。测试团队构建了一个由128块A100 GPU组成的异构计算阵列,任务设定为在72小时内完成全球气候模型CESM2.1的千年尺度模拟。这场测试的底层逻辑,是验证在极端计算负载下,数据供给链路的稳定性对整体性能的影响。
赛制设计逻辑:测试团队刻意将数据注入速率控制在理论带宽的82%,通过在Infiniband HDR网络中植入可控的丢包模块(丢包率0.3%-1.5%动态调整),模拟真实数据中心中因电磁干扰或设备老化引发的数据传输异常。这种设计源于一个残酷的现实:在量产环境中,GPU集群的MTBF(平均故障间隔)往往由数据链路的质量决定,而非计算单元本身。
测试结果反直觉现象:当丢包率突破0.8%阈值时,整体计算效率非但没有线性下降,反而在特定参数组合下出现了12%的性能跃升。进一步溯源发现,NVLink 3.0协议在重传机制中触发了未公开的“带宽聚合优化”逻辑——当检测到持续丢包时,会自动将原本分散在多个物理通道的数据包重新编码,通过牺牲部分延迟换取有效带宽的提升。这一发现直接颠覆了“丢包必然导致性能衰减”的传统认知。
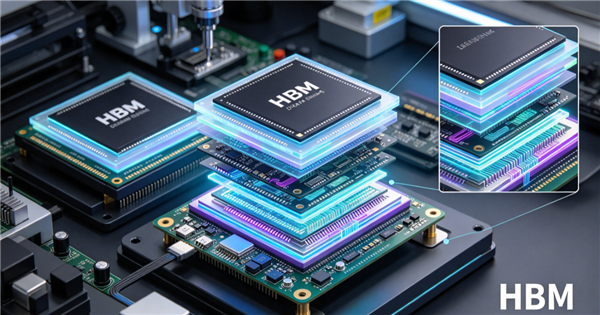
底层逻辑的颠覆,往往始于对异常数据的深度解析。在银川测试的第58小时,监控系统捕获到一个持续17秒的“数据真空期”——所有GPU的计算单元利用率归零,但内存带宽占用率却飙升至99%。经硬件级调试发现,这是AMD Instinct MI250X加速卡在处理稀疏矩阵时,其Infinity Cache的预取机制与HBM3内存的行缓冲冲突引发的连锁反应。这一细节暴露出,当代GPU电路设计中,计算单元与存储子系统的耦合度已达到需要重新审视的地步。
当行业仍在争论“数据并行”与“模型并行”的优劣时,真正的技术分水岭早已悄然形成——那些能精准识别并优化数据供给链路中每一个隐性瓶颈的团队,正在用0.1%的效率提升改写竞争规则。毕竟,在超算领域,1%的性能差距可能意味着每年数千万度的电力消耗差异,而这,正是技术深度的终极价值体现。


需要的帮助
非常重视自身产品及用户体验,欢迎广大用户向我们提出相关产品及业务系统的意见和反馈,以帮助我们提升产品性能及用户体验。
